Data Lake für Industrie- und IoT-Daten
Ein Data Lake ist ein zentraler Speicher, der Daten aus Maschinen, Sensoren und IT-Systemen im Rohformat ablegt, meist auf günstigem Objektspeicher. Die Struktur wird erst beim Auslesen festgelegt. Im IoT-Stack gehört er zur Speicherebene und dient als Datengrundlage für Langzeitanalysen, Reporting und das Training von KI-Modellen.

Schmitz Cargobull 
Head of IT, Techem Gruppe
2 Anwender aus dem Netzwerk haben das schon umgesetzt
Tausch dich mit Anwendern über die Umsetzung aus
Im Anwenderkreis besprechen 300+ Anwender jeden Monat, was in ihren Projekten funktioniert hat und was sie heute anders machen würden. Kein Anbieter im Raum, ehrlicher Austausch unter NDA.
Wer es anbietet
Data Lakes im Praxiseinsatz
1 Hersteller aus unserem Partnernetzwerk mit 18 Lösungsbeispielen. Zuerst die, deren Einsatz in dieser Kategorie am häufigsten belegt ist.
- Kontakt aufnehmen mit Microsoft
Microsoft
Data Lakes18 Lösungsbeispiele
 Condition MonitoringPredictive MaintenanceTraceability (Rückverfolgbarkeit)
Azure Marketplace: TCS Digital Manufacturing Platform
22.06.2023Mehr lesen →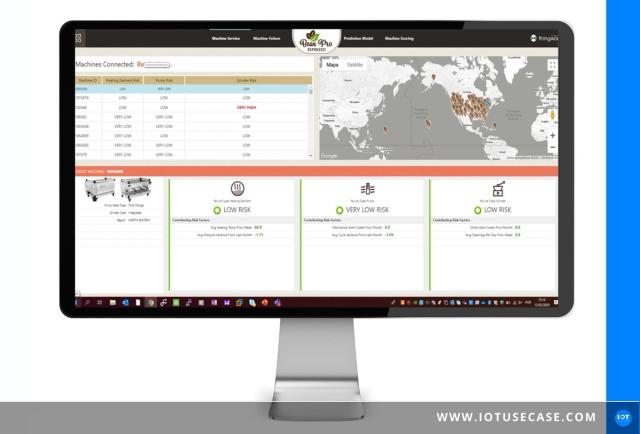
 Condition MonitoringKorrektive InstandhaltungDigitale Dokumentation
Azure Marketplace: Rockwell Automation Industrial IoT platform
19.06.2023Mehr lesen →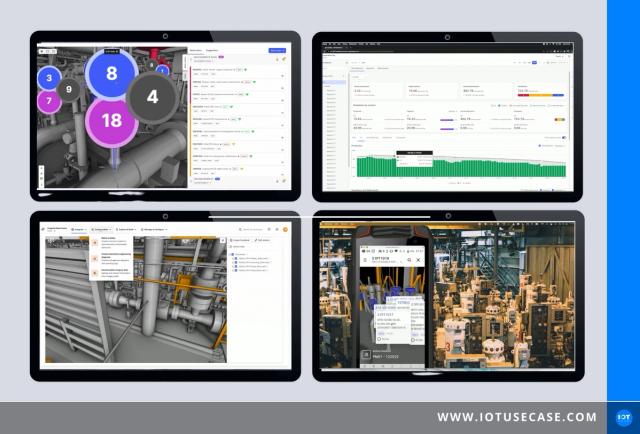
 Condition MonitoringKorrektive InstandhaltungDigitale Dokumentation
Azure Marketplace: Cognite Data Fusion
15.06.2023Mehr lesen →
Wofür es eingesetzt wird
Wofür und womit sie eingesetzt werden
Ausgewertet aus den Lösungsbeispielen dieser Hersteller: die häufigsten Use Cases und die Technologien, die ihre Lösungen sprechen.
Worauf du achtest
Was ein Data Lake ist und wie er funktioniert
Ein Data Lake sammelt Daten aus vielen Quellen an einem Ort, ohne sie vorher in ein festes Schema zu pressen. Zeitreihen von Sensoren, Maschinenzustände, Logdateien, Bilder aus der Qualitätsprüfung und Exporte aus ERP oder MES landen nebeneinander. Technisch basiert ein Data Lake meist auf Objektspeicher, etwa S3-kompatiblen Speichern oder den Data-Lake-Diensten der großen Cloud-Anbieter, in eigenen Rechenzentren auch auf dem verteilten Dateisystem HDFS. Abgelegt werden die Daten oft in offenen Spaltenformaten wie Parquet, darüber liegen Tabellenformate wie Delta Lake oder Apache Iceberg.
Das Prinzip heißt Schema-on-Read: Erst die Auswertung legt fest, wie die Daten gelesen und verknüpft werden. Das macht den Data Lake flexibel für Fragen, die beim Erfassen noch niemand kannte. Speicher und Rechenleistung sind dabei getrennt, sodass große Datenmengen günstig liegen bleiben und nur bei Bedarf ausgewertet werden.
Abgrenzung zu Data Warehouse, Zeitreihendatenbank und Datendrehscheibe
Ein Data Warehouse speichert bereinigte, strukturierte Daten für Berichte und Kennzahlen (Schema-on-Write). Ein Data Lakehouse verbindet beide Ansätze und ergänzt den Data Lake um Tabellen mit Transaktionssicherheit. Für schnelle Abfragen im laufenden Betrieb, etwa für Dashboards am Shopfloor, eignet sich eine Zeitreihendatenbank besser. Eine Datendrehscheibe transportiert und übersetzt Daten zwischen Systemen, speichert sie aber nicht dauerhaft. Hauptgrund für einen Data Lake ist die günstige, langfristige Speicherung großer Rohdatenmengen.
Worauf man bei der Auswahl achtet
Wichtig sind die Anbindung an die Integrationsebene, also ob IT/OT-Middleware, MQTT- oder Kafka-Ströme direkt in den Data Lake schreiben können, sowie offene Datenformate, damit Analysewerkzeuge und KI-Plattformen frei wählbar bleiben. Dazu kommen Zugriffsrechte, Verschlüsselung, Speicherort und Datenhoheit, Lebenszyklusregeln für ältere Daten und ein Datenkatalog mit Metadaten wie Anlage, Einheit und Zeitstempel. Ohne diesen Kontext wird ein Data Lake schnell unübersichtlich.
In der Praxis sammeln Unternehmen im Data Lake Prozess- und Qualitätsdaten über Jahre, um Ausschussursachen zu finden, Energieverbräuche zu vergleichen oder Modelle für vorausschauende Wartung zu trainieren. Aus dem Netzwerk bietet Microsoft einen Data-Lake-Speicher in der Cloud an.
Häufige Fragen zu Data Lakes
Was ist ein Data Lake?
Ein Data Lake ist ein zentraler Datenspeicher, der strukturierte und unstrukturierte Daten im Rohformat aufnimmt. Statt die Daten vorab in Tabellen zu ordnen, wird die Struktur erst bei der Auswertung festgelegt. In der Industrie landen dort zum Beispiel Sensorzeitreihen, Maschinenmeldungen, Prüfbilder und Exporte aus ERP oder MES, die später für Analysen und KI genutzt werden.
Was ist der Unterschied zwischen Data Lake und Data Warehouse?
Ein Data Lake speichert Rohdaten in beliebigem Format, ein Data Warehouse speichert bereinigte, strukturierte Daten nach festem Schema. Der Data Lake ist günstiger und flexibler, eignet sich für große Mengen und KI-Training. Das Data Warehouse liefert schnelle, verlässliche Kennzahlen für Berichte. Viele Unternehmen nutzen beides: Rohdaten im Data Lake, verdichtete Kennzahlen im Warehouse.
Was ist ein Data Lakehouse?
Ein Data Lakehouse ist ein Data Lake mit zusätzlicher Tabellenschicht, die Funktionen eines Data Warehouse ergänzt. Offene Tabellenformate wie Delta Lake oder Apache Iceberg bringen Transaktionssicherheit, Versionierung und Schemaverwaltung auf den günstigen Objektspeicher. So lassen sich Berichte und KI-Auswertungen auf derselben Datenbasis betreiben, ohne Daten in ein separates Warehouse zu kopieren.
Wie ist eine Data-Lake-Architektur aufgebaut?
Eine Data-Lake-Architektur besteht meist aus Aufnahme, Speicherung, Aufbereitung und Bereitstellung. Daten kommen über Middleware, MQTT oder Kafka herein und landen zunächst unverändert in einer Rohdatenzone. Darauf folgen bereinigte und angereicherte Zonen, oft in Parquet- oder Tabellenformaten. Ein Datenkatalog beschreibt Herkunft und Bedeutung, Zugriffsrechte regeln, wer welche Daten nutzen darf.
Data Lake oder Zeitreihendatenbank: was eignet sich für IoT-Daten?
Für schnelle Abfragen im laufenden Betrieb eignet sich eine Zeitreihendatenbank, für die langfristige Speicherung großer Mengen ein Data Lake. Zeitreihendatenbanken liefern aktuelle Messwerte sehr schnell für Dashboards und Alarme. Der Data Lake hält Daten über Jahre günstig vor und verbindet sie mit Qualitäts- und Auftragsdaten. In vielen Architekturen laufen beide parallel.
Im Podcast
Folgen mit diesen Herstellern und ihren Kunden.
Verwandte Kategorien
Weitere Kategorien derselben Ebene und die Technologien, über die Lösungen dieser Kategorie angebunden werden.